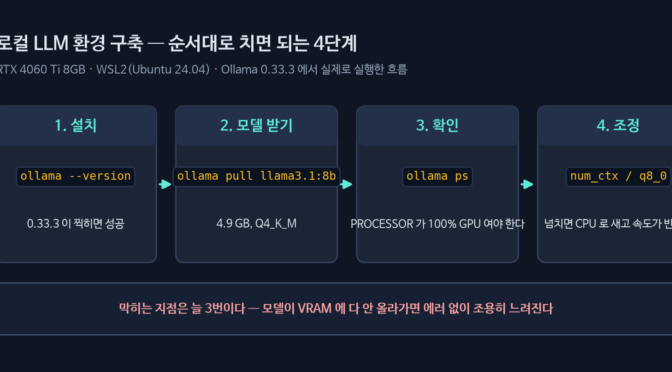
이 글을 따라 하면 되는 것과, 내 환경
예전에 로컬 LLM 환경 구축을 주제로 글을 하나 썼는데 “무슨 말인지 모르겠다”는 말을 들었다. 다시 열어 보니 맞는 지적이었다. 메모리 예산이 어떻고 KV 캐시가 어떻고 이론만 늘어놨지, 정작 독자가 복사해서 칠 덩어리가 없었다. 그래서 갈아엎었다. 이 글은 위에서부터 순서대로 따라 치면 8GB 짜리 그래픽카드에서 로컬 LLM 이 뜨는 걸 목표로 한다.
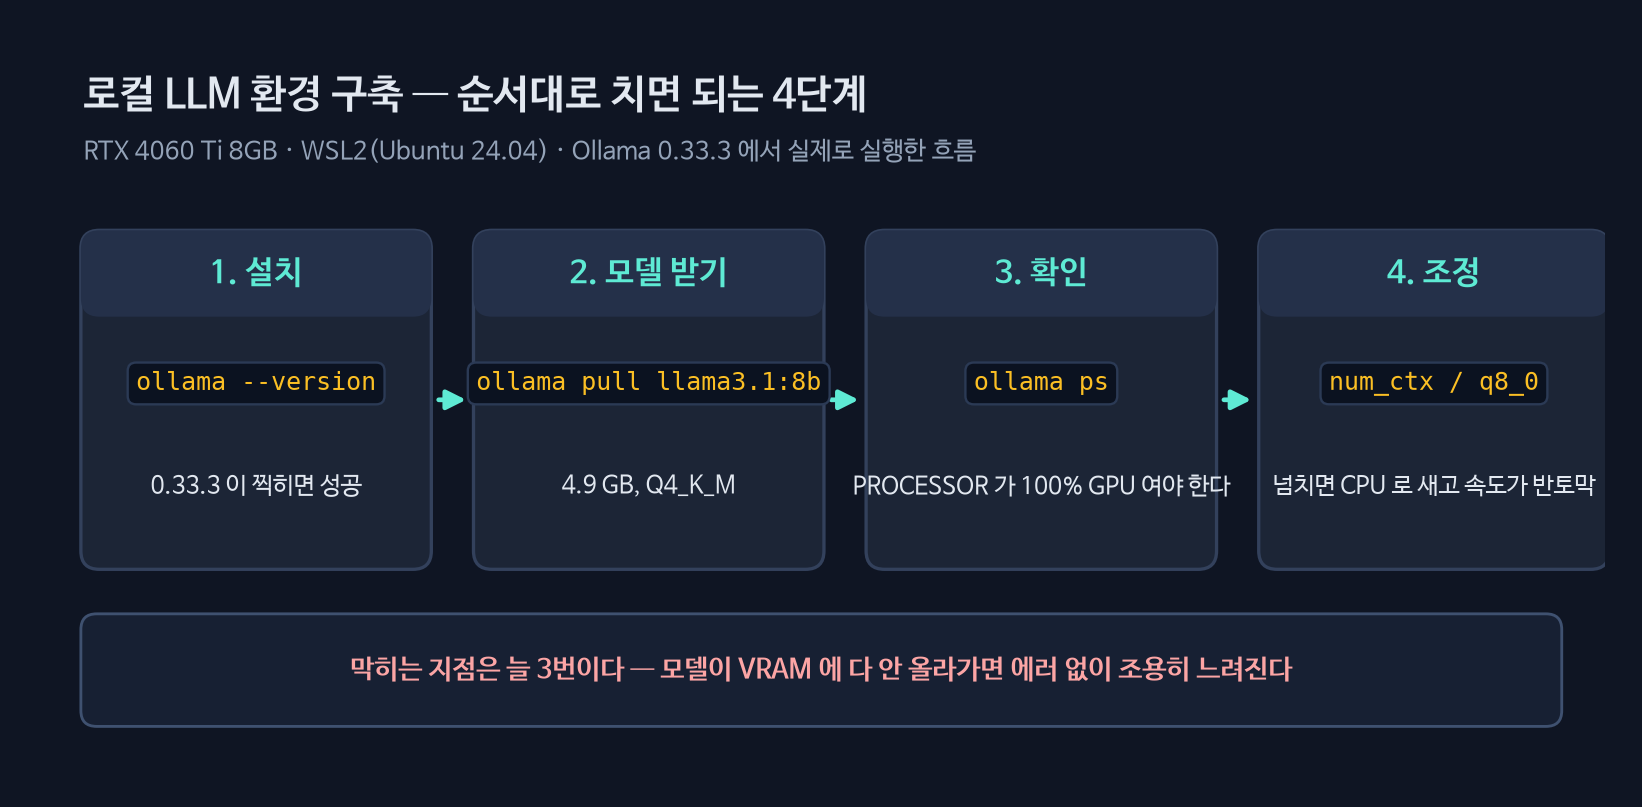
명령어는 환경을 탄다. 내 쪽 조건부터 밝힌다. 아래 나오는 출력은 전부 이 머신에서 나온 값이다.
| 항목 | 값 |
|---|---|
| GPU | NVIDIA GeForce RTX 4060 Ti, VRAM 8188 MiB |
| 드라이버 | 591.86 (Windows 쪽), CUDA 13.1 |
| OS | Windows 위의 WSL2, Ubuntu 24.04.1 |
| RAM / CPU | 15Gi (WSL 안에서 보이는 값), Ryzen 5 7500F, nproc 12 |
| Ollama | 0.33.3 (2026년 9월 기준 최신) |
| 모델 | llama3.1:8b (Q4_K_M, 4.9GB) |
리눅스 네이티브도 흐름은 같고, macOS(Apple Silicon)는 Ollama 가 Metal 을 알아서 잡으니 설치 방법만 다르다.
어디까지 내가 직접 돌렸는지도 먼저 갈라 둔다. 명령어 글에서 이건 정확성 문제라고 생각한다.
- 직접 실행함: 하드웨어 점검, Ollama 수동 설치, 서버 기동, 모델 다운로드, 대화,
ollama ps,nvidia-smi, 컨텍스트 4096·8192·16384·32768 비교, KV 캐시 양자화, 사용자 systemd 서비스 등록,/api/generate와 OpenAI 호환/v1/chat/completions호출. 아래 붙인 출력은 잘라낸 부분을 빼고 그때 나온 그대로다. - 직접 실행 못 함: ① llama.cpp 소스 빌드 — 이 머신에
nvcc가 없어서 CUDA 빌드를 검증할 수 없었다. ② 루트 권한이 필요한 경로 전부 — 공식 설치 스크립트(curl | sh), 그게 만드는ollama.service,sudo systemctl edit ollama. 사용자 서비스로 같은 구조를 만들어 확인하긴 했지만 루트 서비스 그 자체는 아니다. ③.wslconfig메모리 상향. 이 셋은 공식 문서와 설치 스크립트 내용을 정리한 것이고, 본문에서도 그때그때 표시해 뒀다.
0단계 — 내 카드에 뭐가 들어가나 (표 하나로 끝)
로컬 LLM 환경 구축에서 성패를 가르는 건 하나다. 모델이 메모리에 들어가느냐. 유도 과정은 접고 쓸 수 있는 형태로만 남긴다.
가중치가 먹는 메모리는 사실상 GGUF 파일 크기 그대로다. llama.cpp 가 파일을 mmap 으로 올리기 때문이다. 그래서 파일 크기표 하나면 된다. 아래는 Hugging Face 에 실제로 올라와 있는 파일 크기(GiB)를 옮긴 것이다(2026년 9월 확인).
| 모델 | FP16/BF16 | Q8_0 | Q4_K_M | Q4_K_M 이 편하게 들어가는 곳 |
|---|---|---|---|---|
| Llama 3.2 3B | 5.99 | 3.19 | 1.88 | 거의 모든 GPU, 8GB RAM 노트북 |
| Llama 3.1 8B | 14.96 | 7.95 | 4.58 | 8GB VRAM, CPU 16GB RAM |
| Qwen3 14B | 27.51 | 14.62 | 8.38 | 12~16GB VRAM, CPU 32GB RAM |
| Qwen3 32B | 61.03 | 32.43 | 18.40 | 24GB VRAM, CPU 64GB RAM |
규칙은 두 줄이면 된다.
- VRAM 에서 1.5GB 를 빼고, 남는 자리에 들어가는 Q4_K_M 을 고른다. 뺀 1.5GB 는 KV 캐시와 작업 버퍼 몫이다.
- 컨텍스트를 8K 넘게 쓸 거면 1GB 씩 더 뺀다. 8B 모델은 컨텍스트 8,192 토큰마다 KV 캐시가 약 1GiB 붙는다.
내 8188MiB 카드면 8188 − 1500 ≈ 6.7GB 니까 8B Q4_K_M(4.58GiB)이 상한선이다. 14B 는 Q4_K_M 만으로 8.38GiB 라 가중치부터 넘친다. “8GB 카드엔 8B Q4 까지”라는 흔한 경험칙이 여기서 나온다.
자기 머신을 재 보자. 설치 전에 쳐도 되는 명령이다.
nvidia-smi --query-gpu=name,memory.total,driver_version --format=csv
free -h
nproc
lscpu | grep -E 'Model name'
grep -o -w -E 'avx2|avx512f' /proc/cpuinfo | sort -u
내 머신에서는 이렇게 나온다. GPU 이름과 VRAM 총량, 램, 스레드 수, CPU 의 SIMD 지원 여부가 차례로 찍히면 정상이다.
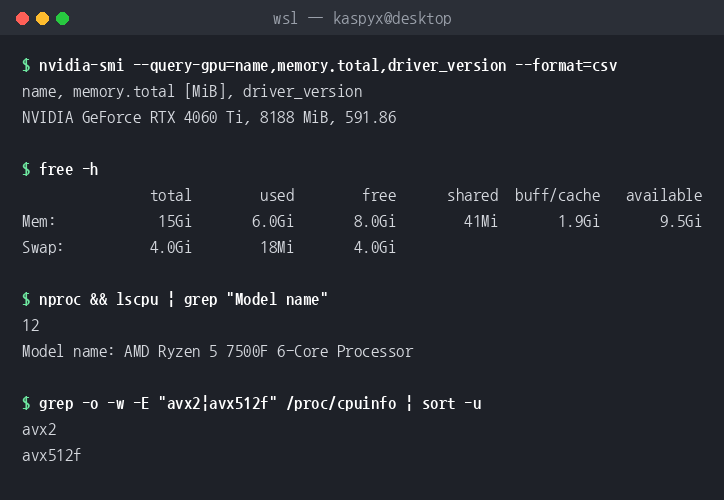
free -h 의 total 이 32GB 머신인데 15Gi 로 나오는 건 램이 빠진 게 아니다. 원인과 조치는 맨 아래 ## 막혔을 때 에 적어 뒀다. GPU 만 쓸 거면 지금은 그냥 넘어가도 된다.
표를 보고 내 카드가 버거워 보이면, 굳이 여기서 붙들 필요는 없다. 무료로 쓸 수 있는 API 를 먼저 붙여 보는 쪽이 빠르다. 어디가 끝까지 공짜인지는 무료 LLM API 리스트에 정리해 뒀다. 반대로 한도가 모자라거나 데이터를 밖으로 안 보내고 싶어서 온 거라면, 그대로 아래로 내려가면 된다.
1단계 — Ollama 설치
sudo 를 쓸 수 있으면 한 줄이다. 공식 문서가 안내하는 방법이고, systemd 서비스까지 등록해 준다.
curl -fsSL https://ollama.com/install.sh | sh나는 이 머신에서 sudo 비밀번호를 넣을 수 없어서 이 한 줄을 쓰지 못했다. 그래서 루트 없이 홈 디렉터리에 까는 경로로 갔다. 같은 처지면 아래를 그대로 따라 하면 된다. 결과물은 똑같이 동작한다.
먼저 배포 파일을 푸는 데 필요한 zstd 를 파이썬으로 대신한다. zstandard 는 pip 로 깔리니 루트가 필요 없다.
pip install zstandard

cat > unzstd.py <<'PY'
import sys, zstandard
zstandard.ZstdDecompressor().copy_stream(
    sys.stdin.buffer, sys.stdout.buffer, read_size=1<<20, write_size=1<<20)
PY
이제 내려받으면서 바로 풀어 홈 디렉터리에 꽂는다. 1.4GB 라 몇 분 걸린다.
mkdir -p ~/ollama-local
curl -fL --silent --show-error https://ollama.com/download/ollama-linux-amd64.tar.zst \
  | python unzstd.py \
  | tar -xf - -C ~/ollama-local
경로를 잡고 버전을 확인한다.
export PATH="$HOME/ollama-local/bin:$PATH"   # .bashrc 에도 넣어 두면 편하다
ollama --version
이렇게 나오면 설치 성공이다.
Warning: could not connect to a running Ollama instance
Warning: client version is 0.33.3
경고 두 줄이 떠서 실패한 줄 알기 쉬운데 아니다. 위 줄은 서버가 아직 안 떠 있어서 나는 경고고, 아래 줄에 client version 이 찍혔다는 게 바이너리가 제대로 깔렸다는 뜻이다. 수동 설치는 systemd 서비스를 등록하지 않으니 서버는 다음 단계에서 손으로 띄운다.
WSL2 사용자 주의. GPU 를 붙이겠다고 WSL 안에
nvidia-driver-XXX같은 리눅스 디스플레이 드라이버를 깔면 안 된다. NVIDIA 의 CUDA on WSL 가이드가 못박아 둔 사항이다. WSL2 는 Windows 쪽 드라이버가libcuda.so로 자동 매핑되는 구조라, 안에서 드라이버를 깔면 그 매핑을 덮어써서 GPU 인식이 통째로 깨진다. 리눅스에 익숙할수록 반사적으로 손이 가는 자리다.
2단계 — 서버 띄우고 GPU 를 잡았는지 확인
여기서부터는 1단계에서 어느 길로 갔느냐에 따라 명령이 갈린다. 로그가 어디 쌓이는지가 다르기 때문이다.
(a) 공식 스크립트로 깐 경우 — systemd 가 ollama.service 를 이미 띄워 뒀다. 따로 실행할 게 없고, 로그는 파일이 아니라 저널에 쌓인다.
systemctl status ollama
curl -s http://localhost:11434/api/version
(b) 수동 설치한 경우 — 서비스가 없으니 직접 띄운다.
nohup ollama serve > ~/ollama-serve.log 2>&1 &
curl -s http://localhost:11434/api/version
어느 쪽이든 {"version":"0.33.3"} 가 돌아오면 서버는 산 거다.
그리고 로그를 꼭 한 번 보고 가자. GPU 를 잡았는지가 두 줄에 다 들어 있다. 여길 건너뛰면 나중에 “왜 느리지”로 돌아온다. 보는 명령은 설치 방식에 따라 다르다.
# (a) 공식 스크립트 / systemd
journalctl -u ollama -n 200 --no-pager | grep -E "inference compute|vram-based"

# (b) 수동 설치 (로그 파일)
grep -E "inference compute|vram-based" ~/ollama-serve.log
내 머신 출력이다. 한 줄이 너무 길어서 앞쪽 타임스탬프는 잘라내고 줄바꿈을 넣었다.
source=types.go:32 msg="inference compute" id=0 library=CUDA compute=8.9
  name=CUDA0 description="NVIDIA GeForce RTX 4060 Ti" libdirs=ollama,cuda_v13
  driver=13.1 type=discrete total="8.0 GiB" available="6.9 GiB"
source=routes.go:2062 msg="vram-based default context"
  total_vram="8.0 GiB" default_num_ctx=4096
읽는 법 세 가지.
library=CUDA— GPU 백엔드를 잡았다. 여기가library=CPU면 아래 단계는 다 해도 소용없다. 드라이버부터 다시 본다.available="6.9 GiB"— 총 8.0GiB 중 실제로 쓸 수 있는 자리. 윈도우 데스크톱이 이미 얼마를 먹고 있어서 8GB 전부가 내 것이 아니다. 0단계에서 1.5GB 를 빼라고 한 게 이거다.default_num_ctx=4096— Ollama 가 VRAM 을 보고 정한 기본 컨텍스트. 8GB 카드에선 4,096 토큰이다. 긴 문서를 넣으면 이 창을 넘는 부분이 에러 없이 조용히 잘려 나간다.
밝혀 둘 게 있다. 나는 sudo 가 없어서 (b) 수동 설치 쪽만 직접 돌렸다. (a) 의
systemctl status ollama와journalctl -u ollama는 루트로 깐 서비스가 있어야 확인되는 명령이라 이 머신에서 그대로 재현하지 못했다. 다만 같은 바이너리를 사용자 서비스로 등록해서journalctl --user -u ollama로 위와 똑같은 두 줄이 나오는 것까지는 확인했다(6단계에 그 방법을 적어 뒀다). 저널에서 읽는 내용은 같고, 다른 건 서비스를 누가 소유하느냐뿐이다.
3단계 — 모델 받고 첫 대화
0단계 표대로 8GB 카드엔 8B Q4 가 상한이니 그걸로 간다. 4.9GB 다운로드다.
ollama pull llama3.1:8b
ollama list
ollama list 가 이렇게 답하면 받아진 것이다. 태그를 생략하면 latest 가 붙고, llama3.1:8b 는 기본 양자화가 Q4_K_M 이다.
NAME           ID              SIZE      MODIFIED
llama3.1:8b    46e0c10c039e    4.9 GB    6 seconds ago
대화는 ollama run 이다. 뒤에 문장을 붙이면 한 번 답하고 빠져나오고, 안 붙이면 대화창으로 들어간다. --verbose 를 붙이면 답 끝에 속도가 붙는다.
ollama run llama3.1:8b --verbose "GGUF 가 뭔지 두 문장으로 설명해줘"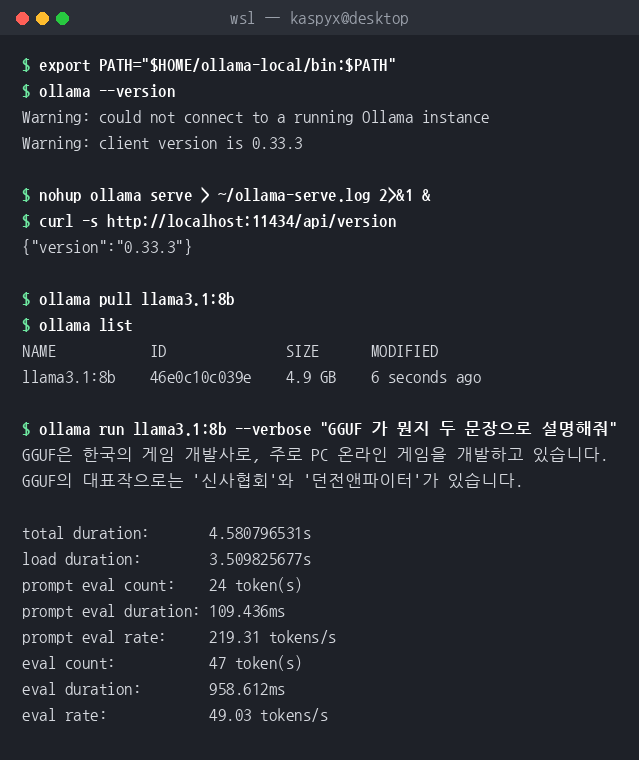
내 화면에 찍힌 그대로 옮기면 이렇다.
GGUF은 한국의 게임 개발사로, 주로 PC 온라인 게임을 개발하고 있습니다.
GGUF의 대표작으로는 '신사협회'와 '던전앤파이터'가 있습니다.

total duration:       4.580796531s
load duration:        3.509825677s
prompt eval count:    24 token(s)
prompt eval duration: 109.436ms
prompt eval rate:     219.31 tokens/s
eval count:           47 token(s)
eval duration:        958.612ms
eval rate:            49.03 tokens/s
답은 보다시피 완전히 틀렸다. GGUF 는 게임 회사가 아니라 llama.cpp 계열이 쓰는 모델 파일 포맷이다. 8B 짜리를 로컬에 띄우면 이런 게 그냥 나온다는 것도 같이 알고 가는 게 좋다. 지금 확인할 건 답의 품질이 아니라 맨 아래 숫자가 찍히느냐다.
봐야 할 줄은 두 개다.
eval rate: 49.03 tokens/s— 생성 속도다. 체감을 결정하는 값이고, 아래 단계에서 계속 이 숫자를 본다.load duration: 3.5s— 모델을 VRAM 에 올리는 데 걸린 시간. 처음 한 번만 나오고, 5분 안에 다시 부르면 0에 가깝게 떨어진다.
prompt eval rate 는 프롬프트를 읽는 속도라 입력이 짧으면 표본이 몇 토큰 안 돼서 들쭉날쭉하다. 여기선 24토큰짜리라 참고만 하면 된다.
4단계 — GPU 에 다 올라갔는지 확인
모델이 GPU 에 전부 올라갔는지는 nvidia-smi 가 아니라 ollama ps 로 본다. 모델은 마지막 요청 뒤 5분간 메모리에 남으니, 방금 대화했다면 바로 치면 된다.
ollama ps
nvidia-smi --query-gpu=memory.used,memory.total --format=csv
NAME ID SIZE PROCESSOR CONTEXT UNTIL
llama3.1:8b 46e0c10c039e 5.3 GB 100% GPU 4096 4 minutes from now
memory.used [MiB], memory.total [MiB]
6022 MiB, 8188 MiBPROCESSOR 열이 100% GPU 면 전부 VRAM 에 올라간 것이다. 여기가 34%/66% CPU/GPU 처럼 쪼개져 나오면 오프로딩이 일어난 거고, 그 순간 속도가 반토막 난다. 다음 단계에서 일부러 재현해 본다.
5단계 — 컨텍스트를 8배 올려 느려지는 걸 눈으로 보기
모델도 그대로, 양자화도 그대로 두고 컨텍스트 길이만 4096 에서 32768 로 올린다. num_ctx 는 API 요청의 options 로 넘기면 되고, 그러면 Ollama 가 모델을 그 컨텍스트로 다시 적재한다.
curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "한 문장으로 답해줘: 캐시 미스는 왜 느린가?",
  "stream": false,
  "options": { "num_ctx": 32768 }
}' | python3 -c 'import json,sys; print(json.load(sys.stdin)["response"])'
그리고 다시 ollama ps 를 친다.
ollama psNAME ID SIZE PROCESSOR CONTEXT UNTIL
llama3.1:8b 46e0c10c039e 9.5 GB 34%/66% CPU/GPU 32768 4 minutes from now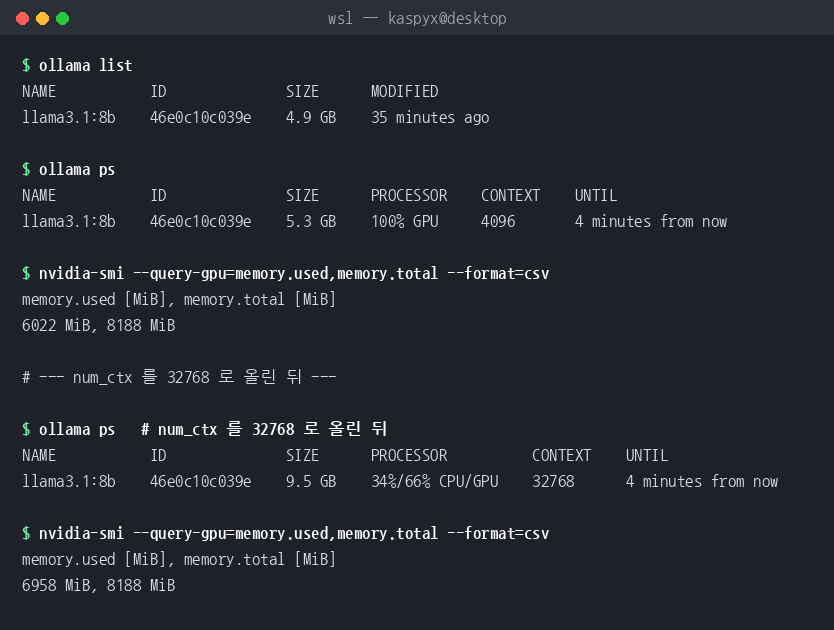
같은 모델, 같은 파일, 같은 카드에서 잰 값을 나란히 놓으면 이렇다.
| 측정값 | 기본 (num_ctx 4096) |
num_ctx 32768 |
|---|---|---|
ollama ps SIZE |
5.3 GB | 9.5 GB |
| PROCESSOR | 100% GPU | 34%/66% CPU/GPU |
nvidia-smi 사용량 |
6022 MiB / 8188 MiB | 6952 MiB / 8188 MiB |
| 생성 속도 (eval rate) | 49.16 tok/s | 20.82 tok/s |
컨텍스트를 8배로 올렸더니 모델이 요구하는 메모리가 뛰었고, 8188MiB 카드에 그게 들어갈 리 없으니 Ollama 가 일부 레이어를 CPU 로 내려버렸다. 생성 속도는 그만큼 주저앉았다.
그런데 nvidia-smi 는 이 사고를 거의 안 보여준다. VRAM 사용량은 오프로딩 전후로 별로 안 변한다. 당연하다. GPU 가 꽉 차서 나머지를 시스템 RAM 으로 흘린 거니까. 그래서 VRAM 숫자만 쳐다보고 있으면 “아직 자리 남았는데 왜 느리지” 하면서 엉뚱한 데를 파게 된다. 오프로딩 판정은 ollama ps 의 PROCESSOR 열로 한다.
범인은 KV 캐시다. 지금까지 처리한 모든 토큰의 Key/Value 벡터를 레이어마다 쌓아 두는 공간이라 컨텍스트 길이에 정비례해서 커진다. Llama 3.1 8B(레이어 32, KV 헤드 8, 헤드 차원 128, FP16)면 토큰당 128KiB 니까 8K 는 1GiB, 32K 는 4GiB 다. 가중치 4.58GiB 에 4GiB 를 얹으면 8GB 카드에 들어갈 방법이 없다. 위 표에서 벌어진 일이 그거 전부다.
6단계 — 좁은 VRAM 에서 되돌리는 세 가지 손잡이
컨텍스트는 필요한데 카드는 8GB 다. 순서대로 이 세 개를 만진다.
(1) 서버 기본값을 필요한 만큼만 올린다. 8GB 카드에서 8,192 는 아직 안전한 값이다.
pkill -x ollama                       # 돌고 있던 서버를 내린다
OLLAMA_CONTEXT_LENGTH=8192 nohup ollama serve > ~/ollama-serve.log 2>&1 &
ollama ps 로 확인하면 요청에 num_ctx 를 안 줘도 CONTEXT 가 8192 로 잡히고, 적재 크기는 5.3GB 에서 5.8GB 로 0.5GB 늘었을 뿐 여전히 전부 GPU 다.
NAME           ID              SIZE      PROCESSOR    CONTEXT
llama3.1:8b    46e0c10c039e    5.8 GB    100% GPU     8192
(2) Modelfile 로 용도별 모델을 굽는다. 컨텍스트와 시스템 프롬프트를 같이 박아 둘 수 있어서 “사내 코드 리뷰어” 같은 걸 만들 때 편하다.
# Modelfile
FROM llama3.1:8b
PARAMETER num_ctx 8192
PARAMETER temperature 0.2
SYSTEM 당신은 한국어로 답하는 C/C++ 코드 리뷰어입니다. 근거 없는 추측은 하지 않습니다.
ollama create c-reviewer -f Modelfile
ollama run c-reviewer "이 코드의 문제를 한 줄로 지적해줘: char b[8]; gets(b);"ollama create 는 마지막에 success 를 찍고 끝난다. 그리고 답은 이렇게 왔다.
gets() 함수는 사용이 금지된 함수로, 버퍼 오버플로를 유발할 수 있습니다.ollama ps 에는 원본이 아니라 구운 모델 이름으로 잡히고, 컨텍스트도 Modelfile 에 박은 8192 가 그대로 붙는다.
NAME                 ID              SIZE      PROCESSOR    CONTEXT
c-reviewer:latest    1724e086b7ec    5.8 GB    100% GPU     8192
(3) KV 캐시를 양자화한다. 컨텍스트를 줄이기 싫을 때 제일 먼저 시도할 손잡이다. KV 캐시를 FP16 대신 8비트로 들고 있으면 그 메모리가 절반이 된다. 플래시 어텐션을 같이 켜야 한다.
pkill -x ollama
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 nohup ollama serve > ~/ollama-serve.log 2>&1 &
서버를 내릴 때
pkill -f "ollama serve"를 쓰면 안 된다.-f는 명령줄 전체를 보기 때문에 그 문자열이 들어 있는 자기 자신(셸)까지 같이 죽인다. 나도 이걸로 두 번 날렸다. 프로세스 이름만 정확히 보는pkill -x ollama를 쓰자.
systemd 로 깔았으면 환경변수를 이렇게 넣는다. 서비스로 뜨는 프로세스는 내 셸의 환경변수를 물려받지 않아서, 위 방식이 아예 안 먹는다. 드롭인 파일에 적어야 한다.
sudo systemctl edit ollama편집기가 열리면 아래를 적고 저장한 뒤 재시작한다.
[Service]
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"
sudo systemctl restart ollama
journalctl -u ollama -n 50 --no-pager | grep -o "OLLAMA_KV_CACHE_TYPE:[a-z0-9_]*"마지막 줄이 OLLAMA_KV_CACHE_TYPE:q8_0 을 뱉으면 적용된 것이다.
나는 sudo 가 없어서 이 루트 서비스 경로를 그대로 돌려보지는 못했다. 대신 같은 구조를 사용자 서비스로 만들어 확인했다. 수동 설치를 해놓고 로그인할 때마다 자동으로 띄우고 싶으면 이쪽이 오히려 편하다.
mkdir -p ~/.config/systemd/user
cat > ~/.config/systemd/user/ollama.service <<EOF
[Unit]
Description=Ollama Service (user)
After=network-online.target
[Service]
ExecStart=$HOME/ollama-local/bin/ollama serve
Restart=always
RestartSec=3
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"
[Install]
WantedBy=default.target
EOF
systemctl --user daemon-reload
systemctl --user enable --now ollama
systemctl --user is-active ollamaactive 가 찍히고, 저널에서도 환경변수와 GPU 인식이 그대로 확인된다.
journalctl --user -u ollama -n 200 --no-pager | grep -E "inference compute|KV_CACHE"이 상태에서 컨텍스트 16384 로 요청하니 5.9 GB / 100% GPU / 48.39 tok/s 가 나왔다. 셸에서 환경변수를 직접 준 앞의 측정(48.83 tok/s)과 같은 결과라, 드롭인으로 넣어도 효과는 동일하다는 걸 확인한 셈이다.
효과가 꽤 크다. 같은 32768 컨텍스트를 다시 재보니 이렇게 바뀌었다.
NAME ID SIZE PROCESSOR CONTEXT
llama3.1:8b 46e0c10c039e 7.6 GB 18%/82% CPU/GPU 32768
memory.used: 6890 MiB / 8188 MiB
eval rate: 30.22 tok/s적재 크기가 9.5GB 에서 7.6GB 로 줄면서 CPU 로 밀려난 몫이 34%에서 18%로 내려갔고, 속도는 20.82 에서 30.22 tok/s 로 올라왔다.
더 재밌는 건 16K 다. 컨텍스트를 16384 로 잡고 KV 캐시 양자화를 껐다 켜 보면 경계가 정확히 어디인지 보인다. 내가 잰 값을 전부 모으면 이렇다. 전부 같은 카드, 같은 llama3.1:8b Q4_K_M 파일이다.
| 컨텍스트 | KV 캐시 | ollama ps SIZE |
PROCESSOR | 생성 속도 |
|---|---|---|---|---|
| 4096 (기본) | FP16 | 5.3 GB | 100% GPU | 49.16 tok/s |
| 8192 | FP16 | 5.8 GB | 100% GPU | 49.23 tok/s |
| 16384 | FP16 | 7.3 GB | 13%/87% CPU/GPU | 33.57 tok/s |
| 16384 | q8_0 | 5.9 GB | 100% GPU | 48.83 tok/s |
| 32768 | FP16 | 9.5 GB | 34%/66% CPU/GPU | 20.82 tok/s |
| 32768 | q8_0 | 7.6 GB | 18%/82% CPU/GPU | 30.22 tok/s |
굵게 칠한 줄이 이 글에서 제일 쓸모 있는 발견이다. 8GB 카드에서 16K 컨텍스트는 그냥 쓰면 오프로딩이 나서 33 tok/s 로 떨어지는데, KV 캐시를 q8_0 로 바꾸면 100% GPU 로 돌아오면서 48.83 tok/s 가 나온다. 기본 컨텍스트일 때 속도(49.16)와 사실상 차이가 없다. 컨텍스트를 네 배로 쓰면서 속도는 그대로인 셈이라, 8GB 카드를 쓴다면 이 환경변수 두 개는 그냥 기본으로 켜 두는 게 낫다고 본다.
32K 는 이걸 켜도 여전히 넘친다. 그건 이 카드에서 무리라는 뜻이고, 그때는 3B 급으로 내려가는 게 맞다.
7단계 — 코드에 꽂기
서버가 떴으면 나머지는 주소 문제다. Ollama 는 자체 API(/api/generate, /api/chat) 말고 OpenAI 호환 엔드포인트도 같이 준다. 그래서 기존 코드를 거의 그대로 꽂을 수 있다.
curl -s http://localhost:11434/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{
"model": "llama3.1:8b",
"messages": [
{"role": "system", "content": "간결하게 한국어로 답한다."},
{"role": "user", "content": "mmap 으로 모델을 읽으면 왜 로딩이 빠른가?"}
],
"temperature": 0.2
}' | python3 -c 'import json,sys; print(json.load(sys.stdin)["choices"][0]["message"]["content"])'받은 답이다.
mmap은 메모리 매핑을 의미하는 것으로, 파일을 메모리에 로드하지 않고
메모리 주소 공간에 파일을 매핑하는 것을 의미합니다.
(이하 줄임)파이썬이면 openai SDK 의 base_url 만 갈아 끼우면 끝난다. api_key 는 SDK 가 빈 값을 거부하니까 아무 문자열이나 넣는다. Ollama 문서도 “필수지만 무시됨”이라고 적어 뒀다.
from openai import OpenAI
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
resp = client.chat.completions.create(
model="llama3.1:8b",
messages=[
{"role": "system", "content": "간결하게 한국어로 답한다."},
{"role": "user", "content": "KV 캐시가 컨텍스트 길이에 비례하는 이유를 한 줄로."},
],
temperature=0.2,
)
print(resp.choices[0].message.content)OpenAI 호환 API 를 받는 CLI 도구나 에이전트 프레임워크면 대개 OPENAI_BASE_URL 과 모델명만 바꿔 같은 식으로 붙는다. 다만 도구마다 function calling·스트리밍·구조화 출력 지원 범위가 다르니, 붙이기 전에 그 도구가 실제로 때리는 엔드포인트가 뭔지는 확인하고 가는 게 안전하다.
8단계(선택) — llama.cpp 로 내려가기
레이어 배치·스레드 수·KV 캐시 타입을 손으로 붙잡아야 하거나, GGUF 를 직접 양자화해야 하거나, 최소 의존성으로 컨테이너에 넣어야 하면 llama.cpp 를 직접 빌드한다.
이 섹션은 이번에 내가 빌드해 보지 않았다. 이 머신에 nvcc 가 없어서 CUDA 빌드를 검증할 방법이 없었다. 아래 명령과 옵션은 공식 빌드 문서를 정리한 것이지 내 터미널 기록이 아니다. 출력 예시를 붙이지 않은 것도 그래서다.
옵션 이름부터 짚고 간다. 오래된 글에는 CUDA 빌드가 -DLLAMA_CUBLAS=ON 으로 적혀 있는데 이 이름은 지금 안 먹는다. 현재 공식 문서 기준 CUDA 옵션은 GGML_CUDA 다. 고약한 건, 존재하지 않는 CMake 옵션을 줘도 빌드가 경고 한 줄 없이 그냥 성공한다는 점이다. 조용히 무시되고 CPU 빌드가 나오니 나중에 “빌드는 됐는데 GPU 를 안 쓴다”로 돌아온다.
sudo apt install -y build-essential cmake git
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
# CPU 전용 빌드
cmake -B build
cmake --build build --config Release -j "$(nproc)"
# CUDA 빌드 (WSL-Ubuntu 용 CUDA 툴킷이 깔려 있어야 nvcc 를 찾는다)
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release -j "$(nproc)"빌드가 끝나면 build/bin/ 에 대화용 llama-cli, HTTP 서버 llama-server, 양자화 도구 llama-quantize, 벤치 llama-bench 가 생긴다.
# GGUF 를 받아서 OpenAI 호환 서버로 띄우기
# -ngl 99 는 "가능한 모든 레이어를 GPU 로", -c 는 컨텍스트 길이
./build/bin/llama-server \
-hf bartowski/Meta-Llama-3.1-8B-Instruct-GGUF:Q4_K_M \
-ngl 99 -c 8192
# 프롬프트 처리(pp)와 생성(tg) 속도를 갈라서 재기
./build/bin/llama-bench -m ./models/model-Q4_K_M.gguf -ngl 99 -p 512 -n 128-c 를 생략하면 안 된다. 생략하면 llama-server 는 모델 메타데이터의 학습 컨텍스트 길이를 그대로 쓰려 드는데, Llama 3.1 은 그게 131,072 다. 0단계 규칙대로면 KV 캐시만 16GiB 를 요구하는 값이라 8GB 카드에 들어갈 방법이 없다. 8GB VRAM 이면 -c 8192 가 무난한 출발점이다.
5단계에서 본 게 이 사고의 순한 버전이다. Ollama 는 자리가 모자라면 알아서 CPU 로 내려 느려지는 선에서 끝났지만, -ngl 99 로 전부 GPU 에 올리라고 못박아 둔 상태면 자리가 없을 때 로딩 단계에서 그냥 죽는다. 어느 쪽이든 원인은 하나, 컨텍스트 길이다.
두 경로는 결국 만난다. Ollama 속에 llama.cpp/ggml 이 들어 있어서 직접 만든 GGUF 를 Modelfile 한 줄로 등록할 수 있고, 반대로 Ollama 가 받아 둔 blob 도 그냥 GGUF 라 llama-server -m 으로 바로 열린다.
그리고 이 글을 덮은 다음에 갈 데가 하나 더 있다. vLLM 이다. 위의 두 경로는 “내 기계에서 나 혼자 쓴다”가 전제인데, 여러 사용자의 요청을 동시에 받아 처리량을 뽑아야 하면 그때부터는 다른 물건이 필요하다. 대략 이렇게 갈린다.
| 이럴 때 | 쓸 것 |
|---|---|
| 혼자 쓰는 개발 환경, 모델을 자주 갈아 끼움 | Ollama |
| 자원이 빠듯해 레이어·스레드·KV 캐시를 손으로 통제, 직접 양자화 | llama.cpp |
| 동시 요청 다수, VRAM 24GB 이상, safetensors 원본을 그대로 | vLLM |
내 8GB 카드로는 vLLM 이 애초에 후보가 아니라 이 글에서는 다루지 않았다. 24GB 이상을 쥐고 여러 명에게 서빙할 상황이 되면 그때 꺼내면 된다.
막혔을 때
내가 이번에 실제로 본 에러부터, 문서가 못박아 둔 함정까지 순서대로 적는다.
curl: (22) The requested URL returned error: 404
수동 설치 URL 로 흔히 도는 .tgz 를 받으면 이게 뜬다.
$ curl -fL -o ollama-linux-amd64.tgz https://ollama.com/download/ollama-linux-amd64.tgz
curl: (22) The requested URL returned error: 404원인: 요즘 Ollama 는 .tgz 가 아니라 .tar.zst 로 배포한다. 설치 스크립트도 .tar.zst 를 먼저 보고 없을 때만 .tgz 로 물러나는데, 0.33.3 에는 .tgz 가 아예 없다.
해결: 확장자를 바꿔서 받는다. 확인은 이렇게 한다. 앞줄이 200, 뒷줄이 404 로 찍힌다.
curl -s -o /dev/null -w "%{http_code}\n" -L -I https://ollama.com/download/ollama-linux-amd64.tar.zst
curl -s -o /dev/null -w "%{http_code}\n" -L -I https://ollama.com/download/ollama-linux-amd64.tgzbash: zstd: command not found
원인: .tar.zst 를 풀려면 zstd 가 필요한데 기본 설치가 아니다. 설치 스크립트도 이 상황에서 이렇게 안내하고 끝낸다.
This version requires zstd for extraction. Please install zstd and try again:
- Debian/Ubuntu: sudo apt-get install zstd해결: sudo 가 되면 그대로 깔면 된다. 안 되면 1단계에 적은 파이썬 zstandard 로 우회한다. pip 는 루트를 안 쓴다.
sudo: a password is required
원인: 공식 설치 스크립트는 /usr/local 에 쓰고 systemd 서비스를 등록해야 해서 루트가 필요하다. 스크립트를 열어 보면 전부 $SUDO 를 달고 있다.
curl -fsSL https://ollama.com/install.sh -o install.sh
grep -n 'SUDO' install.sh | head -6110:SUDO=
117: SUDO="sudo"
148: zstd -d | $SUDO tar -xf - -C "${dest_dir}"
156: $SUDO tar -xzf - -C "${dest_dir}"
166: $SUDO rm -rf "$OLLAMA_INSTALL_DIR/lib/ollama"
169:$SUDO install -o0 -g0 -m755 -d $BINDIR(head -6 으로 잘랐다. 그냥 head 면 10줄이 나오고, 뒤로는 systemd 유닛과 ollama 사용자 생성까지 계속 $SUDO 가 붙는다.)
해결: 1단계의 수동 설치로 간다. 홈 디렉터리에 풀어도 기능은 동일하고, 서버만 ollama serve 로 직접 띄우면 된다.
grep: /home/사용자/ollama-serve.log: No such file or directory
원인: 공식 스크립트로 깔면 systemd 가 서버를 띄우기 때문에 로그가 파일이 아니라 저널에 쌓인다. 그 로그 파일은 2단계 (b) 수동 설치 경로에서만 생긴다. 해결: 저널을 본다.
journalctl -u ollama -n 200 --no-pager | grep -E "inference compute|vram-based"Unit ollama.service could not be found. 가 나오면 반대 경우다. 서비스가 없는 것이니 ollama serve 를 직접 띄우고 로그 파일 쪽을 보면 된다.
환경변수를 줬는데 서버가 무시한다
원인: systemd 서비스로 뜬 프로세스는 내 셸의 환경변수를 물려받지 않는다. OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve 처럼 앞에 붙여 봐야 이미 떠 있는 서비스에는 아무 영향이 없다.
해결: 드롭인에 적는다(6단계 3번). 적용됐는지는 저널에 찍히는 서버 설정 줄로 확인한다.
sudo systemctl edit ollama # [Service] 아래 Environment= 줄 추가
sudo systemctl restart ollama
journalctl -u ollama -n 50 --no-pager | grep -o "OLLAMA_KV_CACHE_TYPE:[a-z0-9_]*"GPU 가 있는데 CPU 처럼 느리다
원인: 십중팔구 오프로딩이다. 모델이 VRAM 을 넘으면 레이어 일부가 CPU 로 내려가고, 그 부분은 GPU 메모리보다 훨씬 느린 DDR5 에서 읽히니 전체가 같이 느려진다. nvidia-smi 로는 잘 안 보인다.
해결: ollama ps 의 PROCESSOR 열부터 본다. 100% GPU 가 아니면 컨텍스트를 줄이거나(6단계 1번), KV 캐시를 양자화하거나(6단계 3번), 더 작은 모델로 내린다.
ollama ps서버 로그에 library=CPU 가 찍힌다
원인: GPU 를 아예 못 잡은 것이다. WSL2 라면 WSL 안에 리눅스 NVIDIA 드라이버를 깔았을 때 자주 이렇게 된다.
해결: WSL 안의 리눅스 디스플레이 드라이버를 지우고, Windows 쪽 드라이버를 최신으로 올린 뒤 nvidia-smi 가 WSL 안에서 정상 동작하는지부터 확인한다. WSL 안에는 CUDA 툴킷만(그것도 WSL-Ubuntu 전용 패키지로) 깐다.
긴 문서를 넣었는데 뒷부분이 조용히 잘린다
원인: 기본 컨텍스트가 8GB 카드 기준 4,096 토큰이다. 창을 넘는 부분은 에러 없이 버려진다. 답이 이상한데 프롬프트를 아무리 고쳐도 그대로면 여기부터 의심한다.
해결: OLLAMA_CONTEXT_LENGTH 나 요청의 num_ctx 로 명시한다. 다만 5단계에서 봤듯 올린 만큼 느려지니 필요한 만큼만 올린다.
32GB 머신인데 free -h 가 15Gi 로 나온다
원인: 램이 빠진 게 아니라 WSL2 의 기본 동작이다. .wslconfig 의 memory 기본값이 호스트 RAM 의 50% 라, 32GB 머신이면 16GB 가 상한이고 커널 몫을 빼면 15Gi 로 보인다.
해결: CPU 로 큰 모델을 밀 거면 윈도우 쪽 %UserProfile%\.wslconfig 에 아래를 적고 PowerShell 에서 wsl --shutdown 을 친다. GPU VRAM 은 이 설정과 무관하다. (나는 8GB 카드에 올릴 모델만 만지는 중이라 이 상한을 그냥 두고 썼다. 이 설정은 문서 기준이고 내가 적용해 본 건 아니다.)
[wsl2]
memory=24GB
CUDA 로 빌드했는데 GPU 를 안 쓴다
원인: 옛 옵션 LLAMA_CUBLAS 를 썼을 때다. 존재하지 않는 CMake 옵션은 경고 없이 무시되고 CPU 빌드가 나온다.
해결: -DGGML_CUDA=ON 으로 다시 빌드한다.
참고 자료
- Ollama 공식 문서 — 설치, 컨텍스트 길이·환경변수, Modelfile 레퍼런스
- Ollama API 문서 — 자체 API 와 OpenAI 호환 엔드포인트 지원 범위
- llama.cpp 빌드 문서 —
GGML_CUDA등 백엔드별 CMake 옵션 - llama-quantize README — 양자화 종류별 비트/가중치 실측표
- Hugging Face GGUF 문서 — GGUF 포맷 설명
- NVIDIA CUDA on WSL 가이드 — WSL 안에 리눅스 드라이버를 깔지 말라는 근거
- Microsoft WSL 설정 문서 —
.wslconfig의memory기본값